開篇:為什麼這一篇必須講清楚 防雷系統健康指數不是一個裝設備、接幾根線、把數據上傳到平臺就算完成的事情。它關係到現場狀態能不能被持續看見,異常能不能被及時識別,事後能不能把原因講清楚,維運能不能真正形成閉環。 在多站點防雷維運平臺、園區站點、基站網路、光伏電站和數據中心中,防雷系統往往不是孤立存在的。它和供電、通信、接地、設備運行、現場環境以及人工維運緊密相關。如果只看單一設備狀態,很容易低估風險,也容易在故障發生後陷入追溯困難。 因此,這一篇的重點不是介紹一個概念,而是把防雷系統健康指數放到真實工程場景中拆開講:它要解決什麼問題,應該看哪些數據,怎樣判斷風險,怎樣轉化為維運動作,最終怎樣沉澱為長期管理能力。 從 數字防雷 的角度看,把分散狀態轉化為可解釋、可排序、可行動的健康指標。這句話聽起來簡單,但背後意味著數據採集、現場適配、平臺算法、告警分級和維運流程必須一起設計。任何一個環節缺失,系統價值都會被明顯削弱。 本節要點: 防雷系統健康指數的核心價值,是把分散的雷擊事件、SPD狀態、接地趨勢和設備告警整合成一個可量化的風險評分。這個評分不是簡單的紅黃綠,而是要讓維運人員在多站點環境下,一眼看出哪個站點風險最高、應該優先處理,從而把有限的維運資源用在最關鍵的地方。 圖2:為什麼這一篇必須講清楚
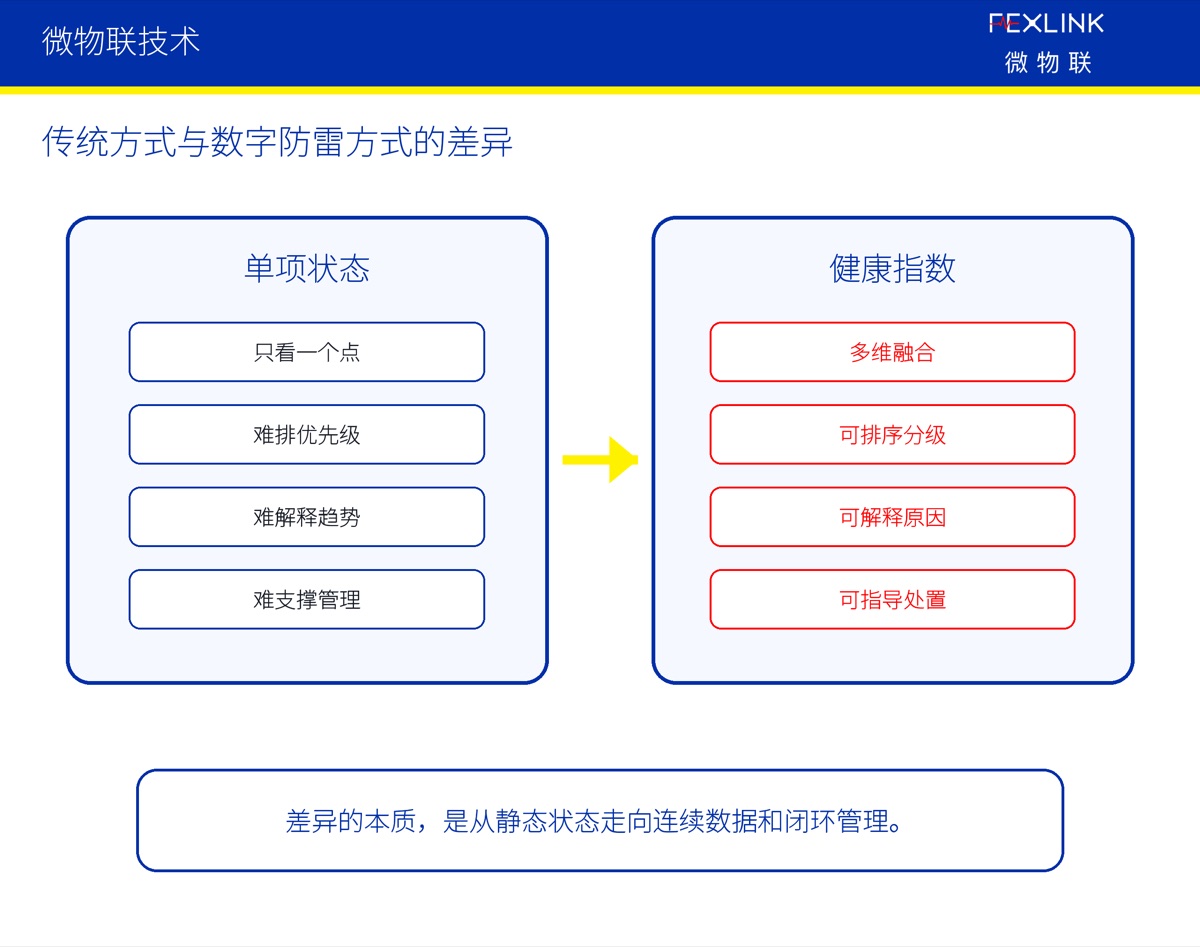
一、傳統方式的核心不足在哪裡 傳統方式最大的問題,是經常把防雷系統看成靜態系統。設備裝上了、檢測合格了、巡檢看過了,就預設系統處在可靠狀態。但實際現場中,雷擊浪湧是隨機的,SPD狀態會變化,接地狀態會變化,設備運行狀態也會變化。 圍繞防雷系統健康指數,傳統工作中常見的痛點是:點位多、狀態多、告警多,但維運人員不知道先處理哪個站點。這個痛點不是某一個專案獨有,而是很多現場在長期維運中都會遇到的問題。 具體到工程現場,很多風險並不是瞬間以故障形式暴露出來,而是先表現為事件發生、狀態輕微變化、趨勢逐步累積,最後才變成設備損壞、通信異常、停機或維護成本上升。 如果沒有過程數據,維運人員只能看到結果,看不到過程。結果就是問題發生後很難說清楚:風險是什麼時候開始的,哪個環節先變化,是否已經有預警信號,是否有過未處理告警。 數字防雷要補齊的,正是這種過程性數據和連續性判斷能力。它不是否定傳統檢測和人工巡檢,而是在傳統防護基礎上增加狀態可知、趨勢可判和結果可追溯。 本節要點: 傳統方式最大的不足,是把防雷系統看成靜態系統,檢測合格就預設可靠。但雷擊是隨機的,SPD會劣化,接地會漂移,設備狀態會變化。圍繞健康指數,傳統痛點是點位多、告警多,維運人員不知道先處理哪個,缺乏統一的風險量化口徑來支撐優先級決策。 圖3:一、傳統方式的核心不足在哪裡
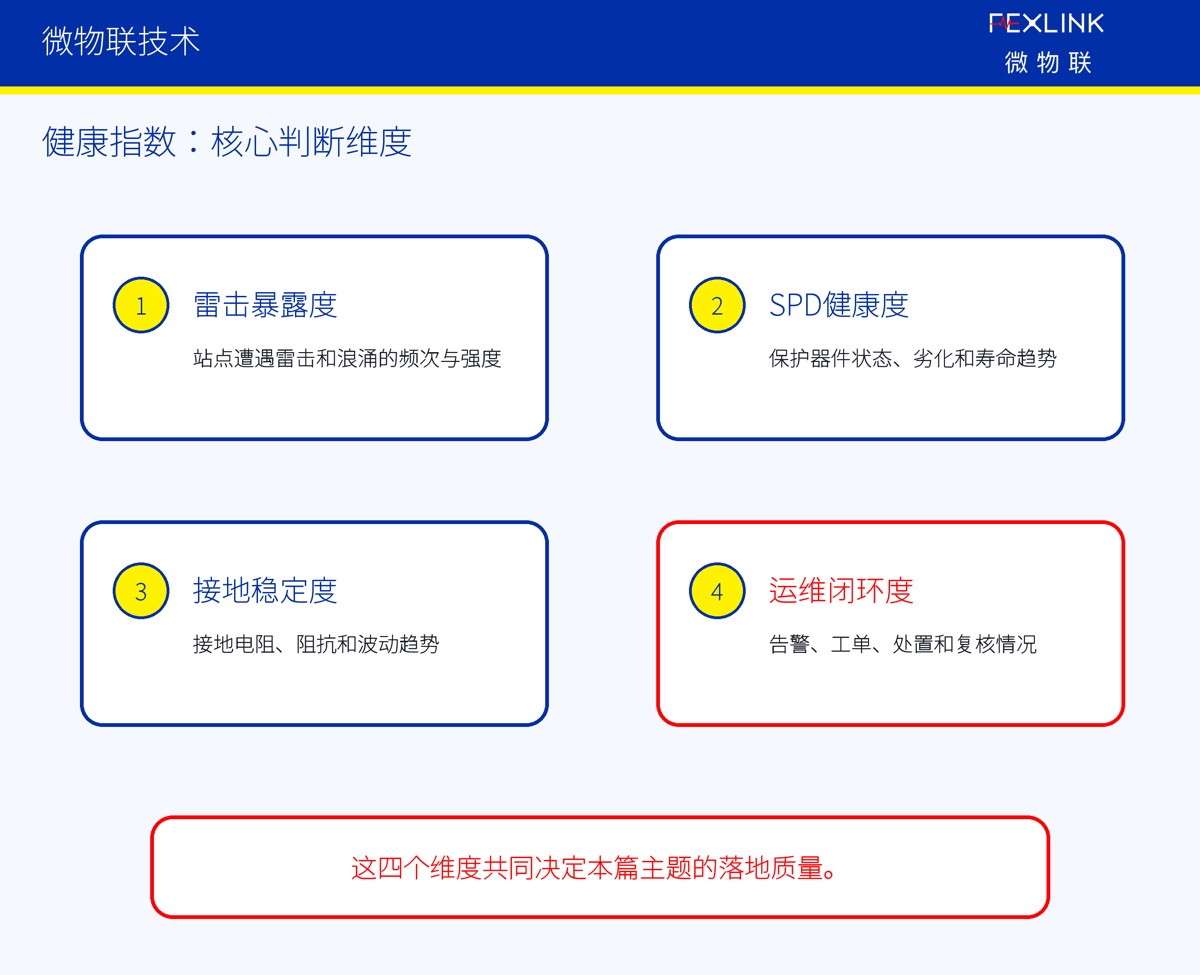
二、應該重點看哪些對象和數據 這一主題下,最關鍵的監測對象包括:雷擊暴露度、SPD健康度、接地穩定度、設備影響度和維運閉環度。這些對象各自回答的問題不同,不能簡單混在一起看。 從數據類型看,需要關注的是:事件頻次、衝擊強度、SPD狀態、接地趨勢、設備告警和工單結果。狀態數據回答現在是什麼狀態,事件數據回答過去發生過什麼,趨勢數據回答風險是否正在變化,處置數據回答問題是否已經解決。 很多系統的問題在於,只採集了一個開關量或者一個計數值,就試圖支撐所有判斷。這樣的數據粒度明顯不足,因為它很難解釋風險原因,也很難指導現場維運。 真正有效的數據體系,應該能把“事件、狀態、趨勢、影響、處置”串起來。比如一次雷擊浪湧事件發生後,系統不僅要知道事件存在,還要知道保護狀態是否變化、接地狀態是否異常、設備有沒有伴隨告警、後續是否派單處理。 只有數據鏈完整,平臺才能從展示系統變成判斷系統。否則,再多圖表也只是把現場狀態搬到屏幕上,並沒有真正形成風險分析能力。 本節要點: 健康指數的建立必須基於五類核心數據:雷擊暴露度反映站點遭受雷擊的頻次和強度,SPD健康度反映保護器是否還能有效工作,接地穩定度反映接地系統是否在變化,設備影響度反映防雷事件對後端設備的影響,維運閉環度反映告警是否被及時處置。 圖4:二、應該重點看哪些對象和數據
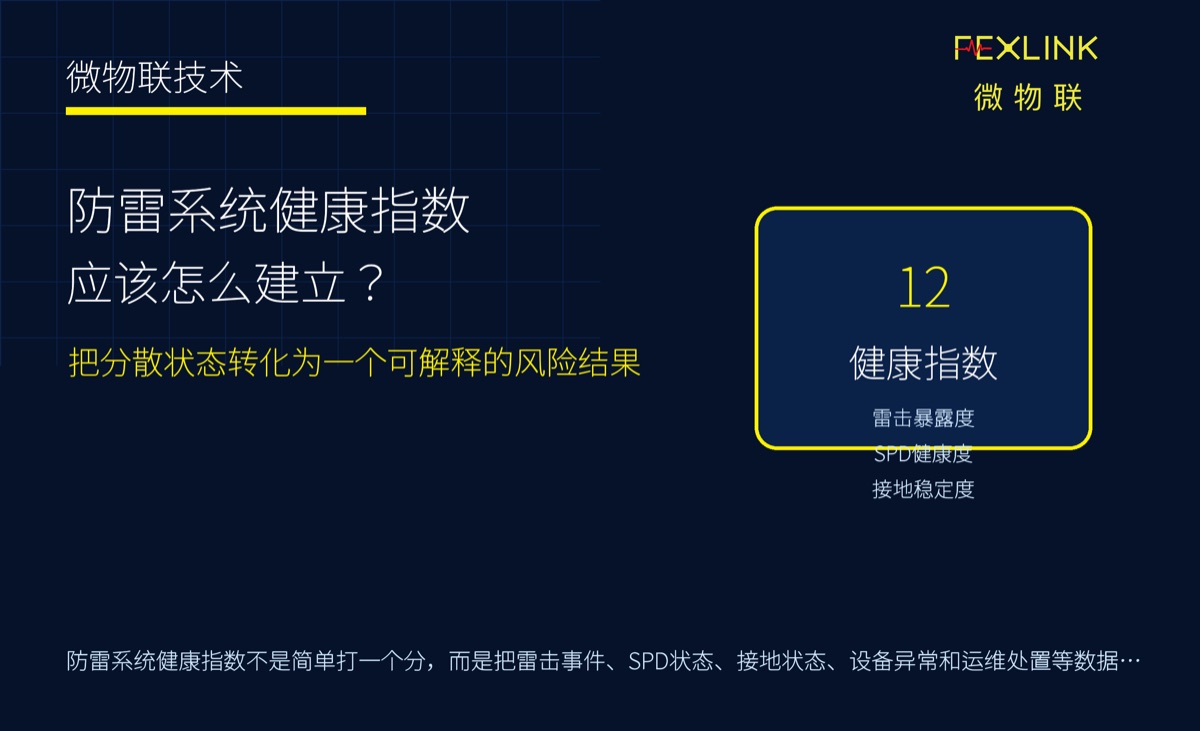
三、如何從數據走向判斷 圍繞防雷系統健康指數,數據採集只是第一步,更重要的是把數據轉化為判斷。判斷至少包括三個層次:是否異常、異常等級多高、異常原因可能來自哪裡。 第一層是狀態判斷。例如某個點位是否離線,SPD是否脫扣,接地是否異常,設備是否出現告警。這一層解決的是有沒有問題。 第二層是趨勢判斷。例如過去一段時間內,雷擊事件是否變多,接地狀態是否持續變差,告警是否重複出現,維修後狀態是否恢復。這一層解決的是風險是否正在發展。 第三層是關聯判斷。例如雷擊事件是否與設備異常時間相鄰,SPD狀態變化是否伴隨接地異常,工單處理後風險指數是否回落。這一層解決的是原因和優先級。 如果平臺只做第一層判斷,價值相對有限;如果能做到趨勢和關聯判斷,數字防雷就能從告警工具升級為維運決策工具。 本節要點: 健康指數的判斷邏輯必須分三層:狀態層判斷當前是否異常,趨勢層評估風險是否在累積,原因層定位風險來自哪裡。指數建模時權重要合理,雷擊頻次、SPD劣化程度、接地變化率不能簡單相加,而要結合站點重要性、設備價值和歷史故障率進行加權計算。 圖5:三、如何從數據走向判斷
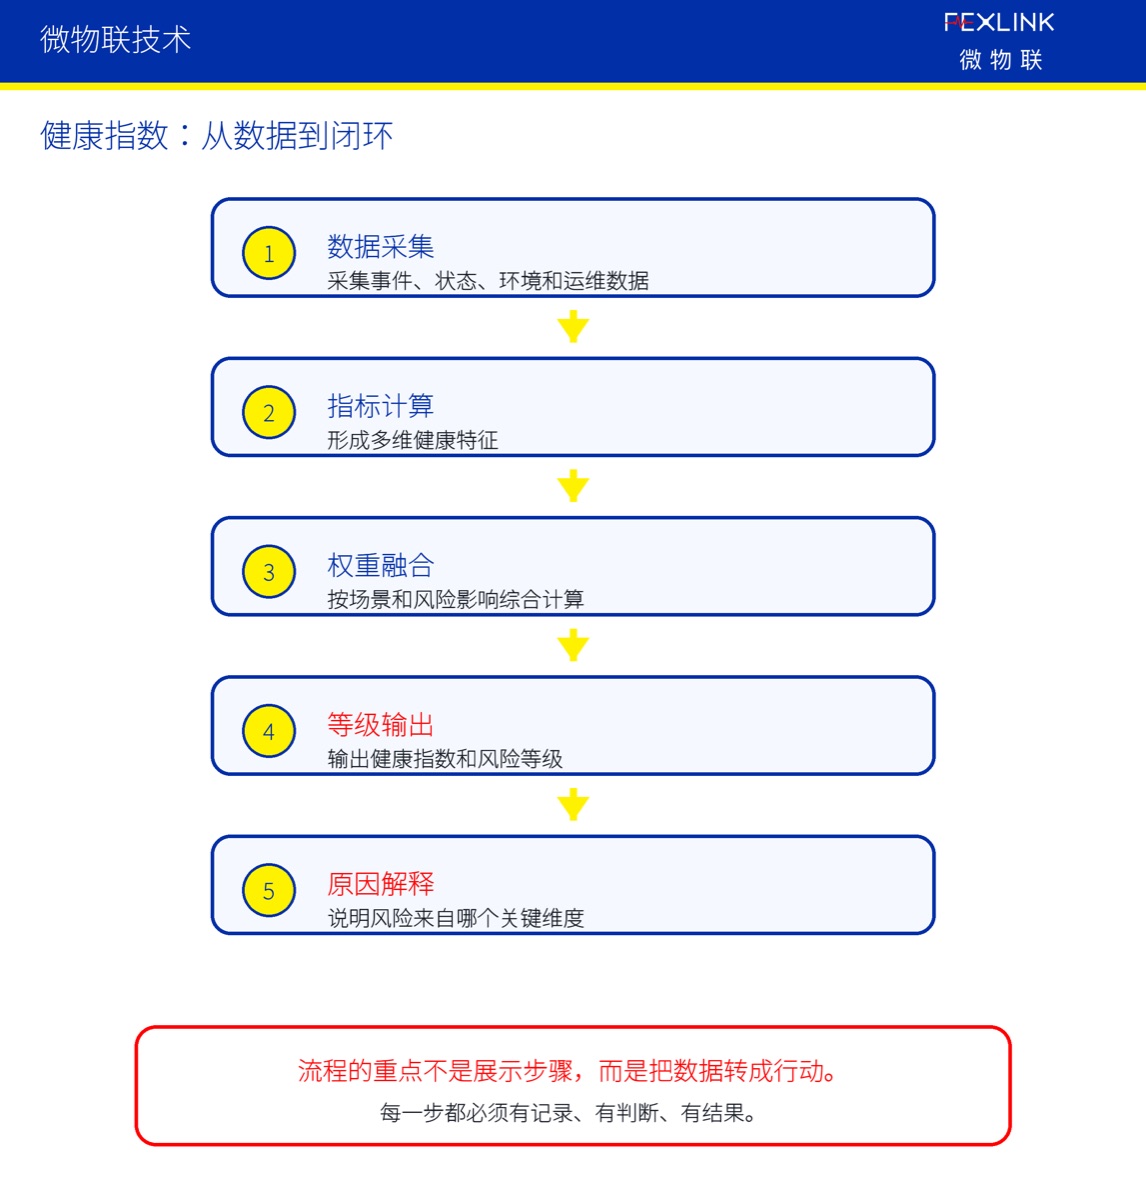
四、如何落到維運閉環 真正落地時,必須把指標建模、權重配置、風險分級、原因解釋和優先級排序串成閉環。也就是說,從數據產生到告警,從告警到工單,從工單到現場處置,從處置到複核歸檔,每一步都要有明確記錄。 很多系統在試點階段看起來很好,因為大屏上有數據、有圖表、有告警。但真正運行一段時間後,問題會暴露出來:告警有沒有人看,派單有沒有責任人,處理有沒有標準動作,複核有沒有依據,長期有沒有統計分析。 維運閉環的價值,是把風險管理從“提醒一下”變成“必須處理並留下證據”。這對於多站點、多設備、多責任方的場景尤其重要。 閉環還可以反向優化系統。哪些告警經常誤報,哪些站點反覆異常,哪些設備壽命消耗更快,哪些處理動作效果更好,這些都可以通過長期工單和狀態數據分析出來。 因此,數字防雷的最終交付不應該只有設備和平臺,還應該包含維運流程、告警規則、責任機制和覆盤機制。 本節要點: 健康指數必須落到維運閉環纔有價值。從指標建模到風險分級,從告警派單到現場處置,從處置複核到指數更新,每一步都要有記錄。很多平臺大屏顯示指數很好看,但告警沒人看、派單沒人跟、處置沒複核,指數就變成了裝飾,無法真正降低風險。
五、這類場景為什麼必須強調“可解釋” 數字防雷不是簡單把現場數據上傳到雲端,也不是用一個紅黃綠狀態代替專業判斷。越是涉及安全和維運決策,越需要系統給出可解釋的原因。 例如在多站點防雷維運平臺、園區站點、基站網路、光伏電站和數據中心中,平臺如果只提示“高風險”,維運人員仍然不知道應該檢查哪裡。系統需要說明風險來自雷擊事件、SPD狀態、接地變化、設備告警還是工單未閉環。 可解釋性還有助於建立用戶信任。工程人員通常不會因為一個分數或一個顏色就立即行動,但如果系統能展示事件時間軸、狀態變化曲線、關聯設備告警和處置建議,行動依據就清晰得多。 未來,數字防雷平臺的競爭力不只是能採多少數據,而是能否把數據解釋成工程語言。讓現場人員看得懂,讓管理人員能決策,讓覆盤人員有證據,這纔是系統真正的專業價值。 本節要點: 健康指數必須可解釋。平臺如果只給出一個分數,維運人員不知道該檢查什麼;系統要能拆解指數構成,說明風險主要來自雷擊事件還是SPD劣化還是接地漂移。可解釋性讓維運決策有依據,也讓指數本身經得起工程檢驗,而不是一個黑箱評分。
結語:數字防雷要服務真實工程,而不是停留在概念層 防雷系統健康指數最終要回答的不是“有沒有一套系統”,而是系統能否長期穩定地服務真實工程。它要能發現狀態變化、解釋風險來源、推動維運動作,並把結果沉澱下來。 微物聯認為,數字防雷的核心是持續生產高品質防雷數據。圍繞雷擊暴露度、SPD健康度、接地穩定度、設備影響度和維運閉環度建立數據鏈,再通過平臺和維運流程形成閉環,才能真正把防雷系統從靜態安裝帶入長期管理。 這也是把分散狀態轉化為可解釋、可排序、可行動的健康指標的根本意義。未來,隨著數據積累,數字防雷還可以進一步服務 電氣安全 早期預警、設備可靠性管理和能源維運智能化。 微物聯/FEXLINK,用數據重構能源效率與電氣安全。 有電,就有微物聯。 返回技術知識列表
核心要點 定義: 防雷系統健康指數不是一個裝設備、接幾根線、把數據上傳到平臺就算完成的事情。它關係到現場狀態能不能被持續看見,異常能不能被及時識別,事後能不能把原因講清楚,維運能不能真正形成閉環。 核心原理: 在多站點防雷維運平臺、園區站點、基站網路、光伏電站和數據中心中,防雷系統往往不是孤立存在的。它和供電、通信、接地、設備運行、現場環境以及人工維運緊密相關。如果只看單一設備狀態,很容易低估風險,也容易在故障發生後陷入追溯困難。 適用場景: 適用場景: 通信基站、風電場、光伏電站、數據中心、充電站、園區配電等需要連續運行、線上安全和資產保護的場景 FEXLINK能力: FEXLINK 圍繞數字防雷建立長期運行數據檔案,包括雷擊事件、浪湧衝擊、SPD狀態、接地狀態、異常告警、維護記錄和風險趨勢,讓防雷系統持續生產安全數據
常見問題 Frequently Asked Questions

防雷系統健康指數應該怎麼建立?的核心內容是什麼? 防雷系統健康指數不是一個裝設備、接幾根線、把數據上傳到平臺就算完成的事情。它關係到現場狀態能不能被持續看見,異常能不能被及時識別,事後能不能把原因講清楚,維運能不能真正形成閉環。。FEXLINK 圍繞數字防雷建立長期運行數據檔案,讓防雷系統從「裝置存在」升級為「狀態可知」。。